1.
购买前准备与网络带宽测试
(1)确认区域:AWS 香港区为 ap-east-1,购买之前核对可用区和机型是否支持该区域。(2)机型选择:根据业务选择通用型(t3/t3a/m5)或计算/网络优化型(c5/nitro 系列)。
(3)带宽需求:对外出口带宽按并发和最大带宽估算,例如视频直播需 100Mbps+。
(4)延迟测试:使用 ping/traceroute 测试与主要用户群的 RTT,香港到中国南方常见 RTT 20–50ms。
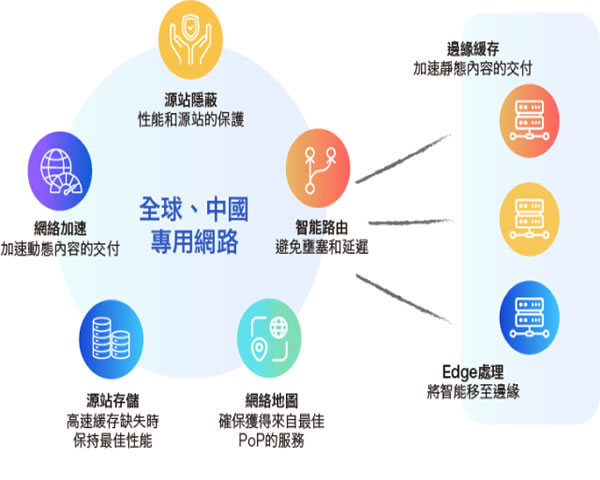
(5)网络优化:必要时配置弹性公网 IP、专线(Direct Connect)或云加速/CDN 层以减少延迟和带宽压力。
(6)安全准备:提前规划安全组、NACL、以及备案/域名策略,确保后续部署顺利。
2.
CloudWatch 基础监控与自定义指标配置
(1)默认指标:EC2 会提供 CPUUtilization、NetworkIn/Out、DiskReadOps/WriteOps 等基础指标。(2)内存/磁盘使用:Linux 需要安装 CloudWatch Agent 才能上报内存、swap、磁盘使用率等自定义指标。
(3)示例 agent 配置:/opt/aws/amazon-cloudwatch-agent/bin/amazon-cloudwatch-agent-ctl --start --config file。
(4)采集频率:关键指标建议 1 分钟粒度;非关键可用 5 分钟以节省费用。
(5)自定义命名空间:建议使用公司前缀如 MyCompany/EC2/HK 方便筛选与统计。
(6)指标保留:CloudWatch 默认保留历史数据,长期趋势分析可导出至 S3 或 Athena。
3.
报警策略与阈值建议
(1)CPU 报警:CPUUtilization >= 70% 持续 5 分钟触发为常见阈值,高并发应用可设置 80%/3 分钟。(2)内存报警:MemoryUtilization >= 80% 持续 3 分钟触发(通过 CloudWatch Agent 上报)。
(3)磁盘报警:DiskFree < 10GB 或 DiskUtilization >= 85% 触发,防止日志塞满导致服务异常。
(4)网络报警:NetworkIn/Out 突增或持续低流量均需报警,异常出站流量结合 DDoS 防护策略处理。
(5)系统状态检查:StatusCheckFailed_Instance 或 System 连续 2 次失败立即报警并触发自动恢复。
(6)报警动作:报警可通过 SNS 推送邮件/短信,也可触发 Lambda 自动扩容、重启或切换到备用主机。
4.
报警策略示例表(示范配置)
以下为常见报警配置示例(示范用,按需调整):| 序号 | 监控项 | 监控周期 | 阈值 | 动作 |
|---|---|---|---|---|
| 1 | CPUUtilization | 1 分钟 | >=70% 持续 5 分钟 | SNS 通知 + Auto Scaling 扩容 |
| 2 | MemoryUtilization | 1 分钟 | >=80% 持续 3 分钟 | SNS 通知 + 创建工单 |
| 3 | DiskFree | 5 分钟 | <10GB | SNS 通知 + 自动清理脚本(Lambda) |
| 4 | StatusCheckFailed_Instance | 1 分钟 | 等于 1 | SNS 通知 + 恢复自动化 |
5.
自动化响应与运维效率提升技巧
(1)使用 SNS + Lambda:报警触发 SNS,Lambda 执行自愈脚本(如重启服务、清理日志)。(2)Auto Scaling 策略:针对 stateless 服务设置基于 CPU/请求率的自动扩缩,节省成本并保证可用性。
(3)Runbook 与自动化:常见故障建立 runbook,将重复操作脚本化,通过 SSM 自动执行。
(4)多层防护:结合 AWS Shield Advanced 或第三方 CDN(CloudFront/阿里云 CDN)做 DDoS 防护与缓存加速。
(5)日志与可观测:集中化日志(CloudWatch Logs / ELK),建立仪表盘(CloudWatch Dashboard)便于快速定位。
(6)成本控制:监控实例闲置率、EBS IOPS 与快照空间,定期清理历史快照与未使用弹性 IP。
6.
真实案例:电商网站在香港区域的监控实践
(1)背景:某区域电商峰值并发约 12,000 RPS,目标用户以东南亚和港澳为主,部署在 ap-east-1。(2)实例配置:Web 层使用 m5.large x6(vCPU 2/内存 8GB),数据库使用 db.m5.large + 多 AZ 只读副本。
(3)CloudWatch 配置:CPU 采样 1 分钟、应用自定义请求延迟(p95)上报、内存上报通过 CloudWatch Agent。
(4)报警策略:p95 延迟 > 800ms 持续 2 分钟触发扩容;CPU > 75% 持续 5 分钟触发扩容或故障排查。
(5)效果:通过自动扩缩与提前报警,单次促销期间可将平均响应时间从 950ms 降到 420ms,可用性提升 99.95%。
(6)后续建议:结合 CDN 缓存热点页面和图片,使用 WAF + Shield 控制异常流量,进一步降低原站压力。